Learning to Drive is a Free Gift: カメラ姿勢情報のない実走行動画を活用した、自動運転システムの大規模なラベルなし事前学習
人は、自分で車を運転するようになる前から、道路環境に関する知識を身につけています。LFG はこの考え方を自動運転システムに応用し、高コストなラベル付きセンサーデータの代わりに、ラベルなしの数百万本の車載カメラ映像を使って事前学習を行います。
現在、自動運転システムの学習には、調整済みの複数センサーを搭載した車両、数百万マイルに及ぶ走行データ、そして多大な手間を要するラベル付けなど、膨大な量の専用データと作業が必要です。こうしたデータの収集には多くの時間とコストがかかり、新たな都市や走行条件に対応して規模を拡大することも容易ではありません。
一方、世界中の人々がさまざまな状況で運転する様子を収めた車載カメラ映像は、オンライン上に数百万時間分も公開されています。人が自分で車を運転するようになる前から道路環境に関する知識を身につけるように、こうした映像には、道路がどのように見えるか、物体がどう動くか、走行シーンがどのように展開するかについて、豊富な情報が含まれています。しかし、ラベルが一切付いていないため、これまで十分に活用されてきませんでした。
ここで紹介するLFG (Learning to Drive is a Free Gift) は、このギャップを埋めるための研究です。複数の既存 AI モデルを教師として活用し、それぞれがラベルなしの車載カメラ映像の異なる要素にラベルを付与します。その情報をもとに、現在のシーンを再構築し、次に起こることを予測する新たなモデルを学習させます。
走行向けにファインチューニングしたこのモデルは、前方カメラ 1 台のみを使用しながら、より豊富なセンサーを備えたシステムを上回る性能を発揮します。この研究成果をまとめた論文は、CVPR 2026 に採択されています。
現在の自動運転システム開発には、3D Lidarスキャン、高精度地図、人手でアノテーションされたバウンディングボックス、熟練ドライバーの走行軌跡など、コストの高いラベル付きデータが大量に必要です。こうしたデータの収集には時間とコストがかかり、さまざまな地域や走行条件へ展開することも容易ではありません。
一方、インターネット上には膨大な車載カメラ映像が存在します。毎年数百万時間分の映像がアップロードされ、世界各地の多種多様な道路、天候、交通状況、運転スタイルが収められています。無料で大量に入手でき、実際の運転環境の複雑さを捉えたデータであるにもかかわらず、ラベルは一切付いていません。深度情報も、カメラ姿勢情報も、意味情報もなく、あるのは未加工のピクセルデータだけです。
ラベルなしデータを用いた大規模事前学習は、すでに言語やコンピューター ビジョンの分野を大きく変えています。LFG が問いかけるのは、同じことを自動運転でも実現できるかということです。カメラ姿勢情報のない動画から、幾何構造、動き、シーンの理解を直接学習し、その知識を自動運転の性能向上に活かすことはできるのでしょうか。
LFG は、連続する数フレームの車載カメラ映像を入力として受け取り、現在のシーンとその先の展開について、さまざまな情報を出力します。
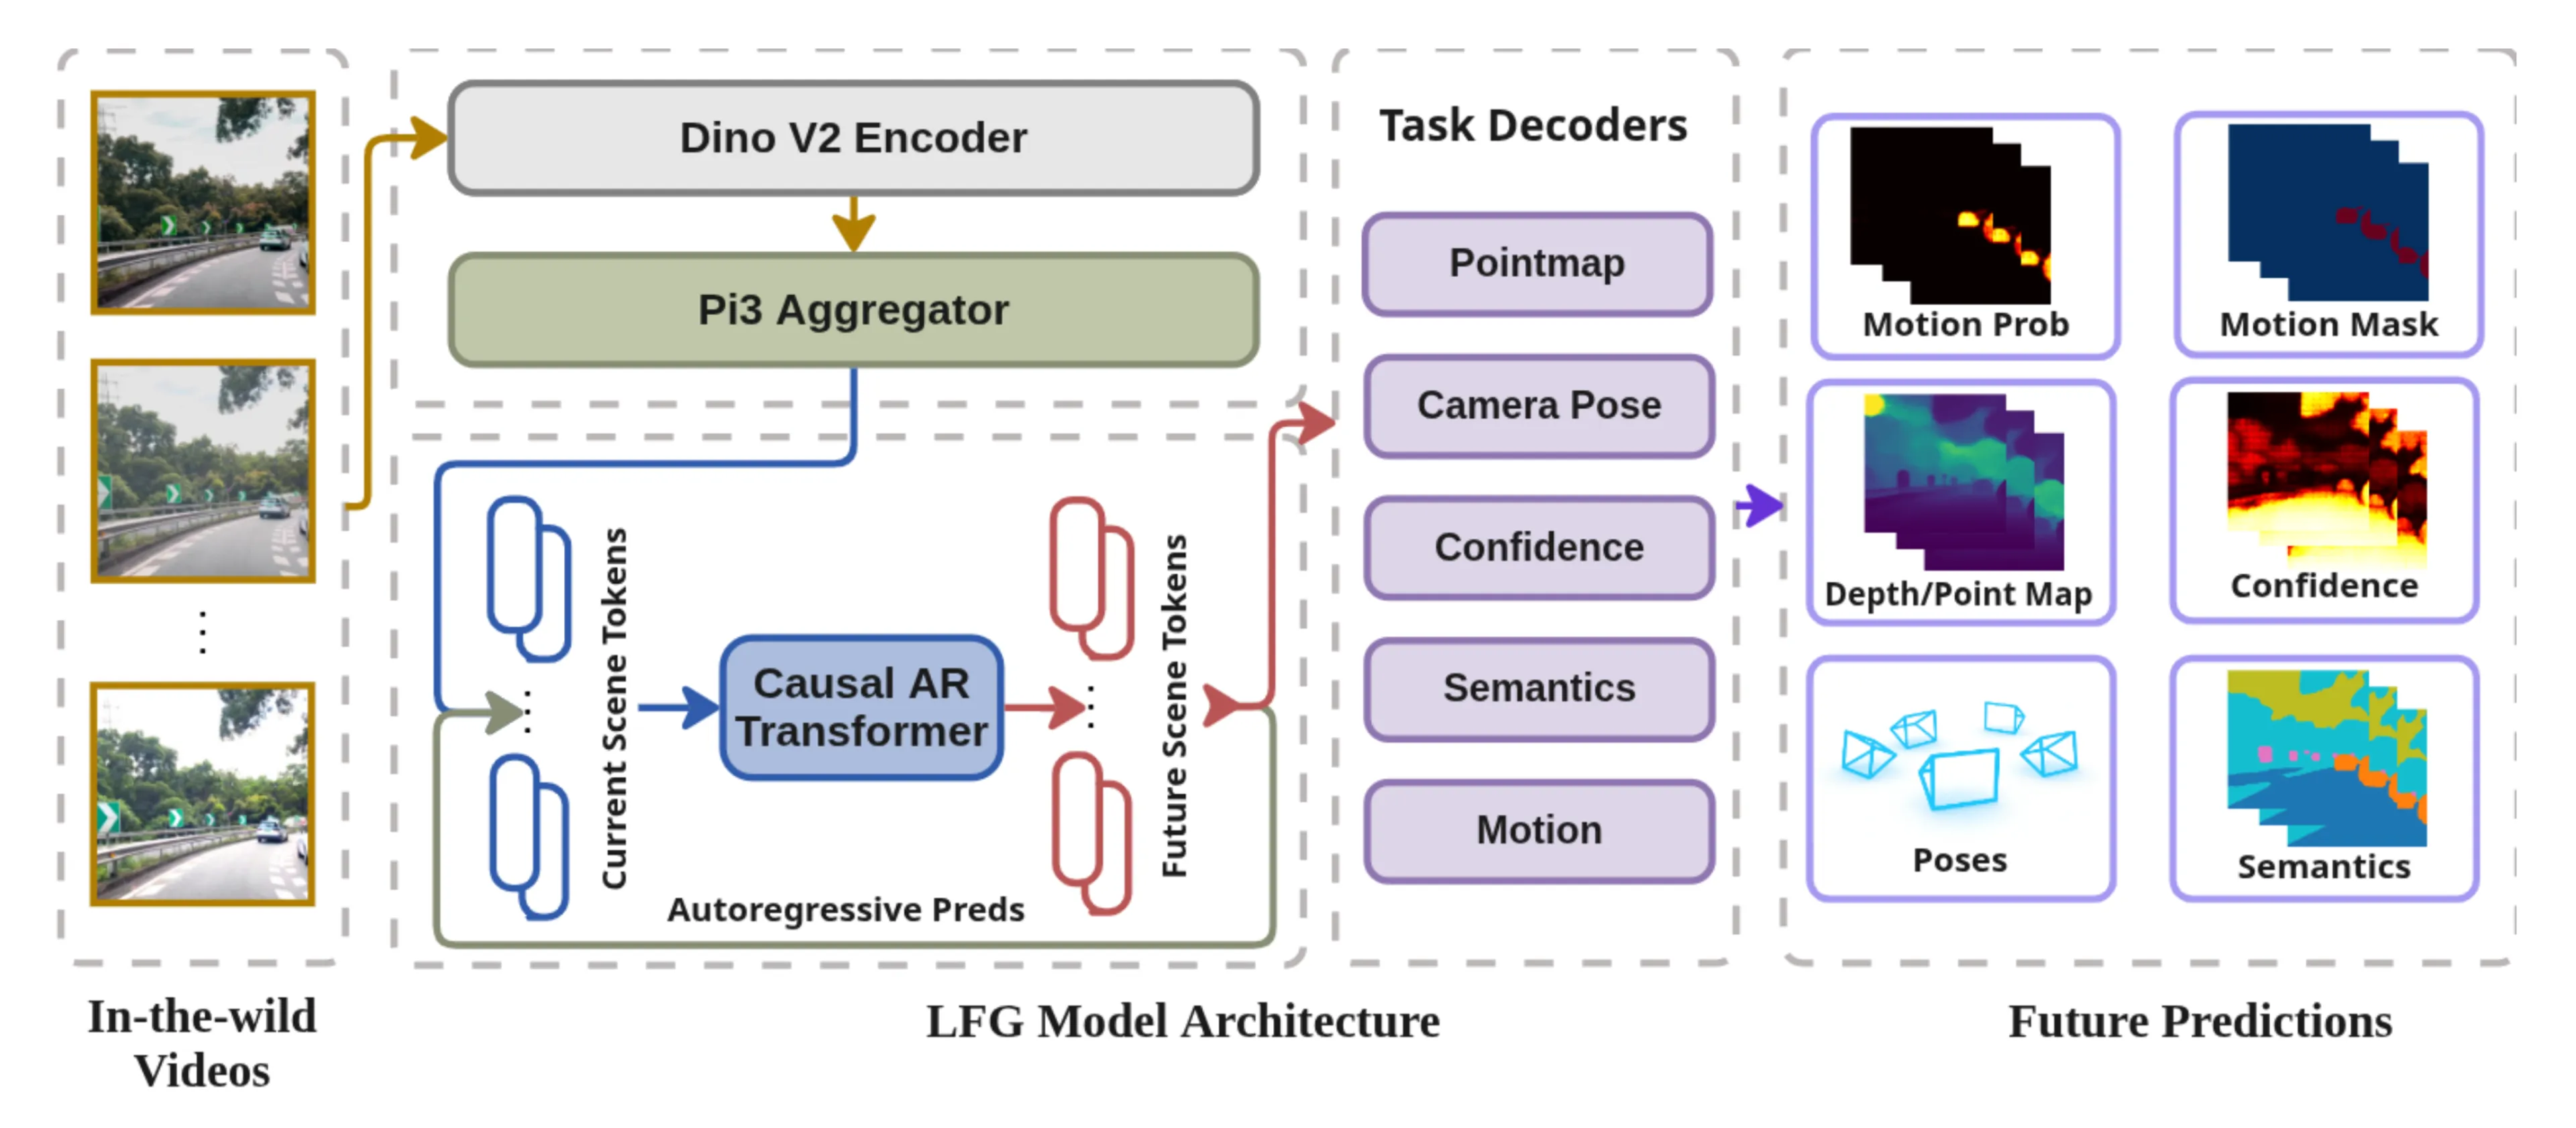
これらの学習に正解ラベルは一切必要なく、代わりに教師モデルと生徒モデルを用いた学習方式を採用しています。特定のタスクに強みを持つ複数の既存モデルが、ラベルなし動画に疑似的な教師信号を与えます。3D 幾何構造、シーンの意味情報、動く物体の検出と追跡は、それぞれ異なる教師モデルが担います。
生徒モデルに与えられるのは、各映像クリップの冒頭数フレームのみです。一方、教師モデルは映像全体を参照します。この仕組みによって、生徒モデルは次に起こることを予測する能力を身につけます。
システム全体は、無料で公開されている走行動画から抽出した約 200 万本の映像クリップを使って学習しており、さまざまな道路環境、走行条件、交通状況を網羅しています。


LFG は、未加工のラベルなし走行動画を用いた大規模事前学習が、より高性能でデータ効率に優れた自動運転システムを実現する有力なアプローチであることを示しています。無料で公開されているインターネット上の映像を学習に活用することで、従来の手法を制約してきたデータのボトルネックを解消します。
本稿は、情報提供のみを目的としています。本稿で言及または掲載されている映像を含め、オンライン上で公開されている映像その他のコンテンツの使用について、本稿のいかなる内容も、Applied Intuition, Inc. (以下「Applied」) がこれを推奨し、ライセンス、権利もしくは許可を付与し、またはそれらが存在することを表明するものと解釈されるべきではありません。
当該映像を使用する場合、使用者は、適用されるライセンス条件を自ら確認し、必要なすべての権利、許可および承認を適切な権利者から取得する責任を負います。Applied は、当該映像の使用または本稿への依拠に起因し、もしくは関連して生じる一切の責任を明示的に否認します。
リサーチ エンジニア
Applied Intuition リサーチ エンジニアであり、自動運転システム向けの3D再構成およびセンサーキャリブレーションを専門とする。ENSEEIHT (フランス国立高等電気工学・電子工学・情報工学・水力工学・通信学校) にて工学の学位およびコンピュータサイエンスの修士号 (研究修士) を取得。その後、Huaweiとブルゴーニュ大学の共同研究プロジェクトの一環として博士号を取得。博士課程では、時空間センサーキャリブレーションを目的としたNeRF (Neural Radiance Fields) および 3D Gaussian Splatting に関する研究に従事。